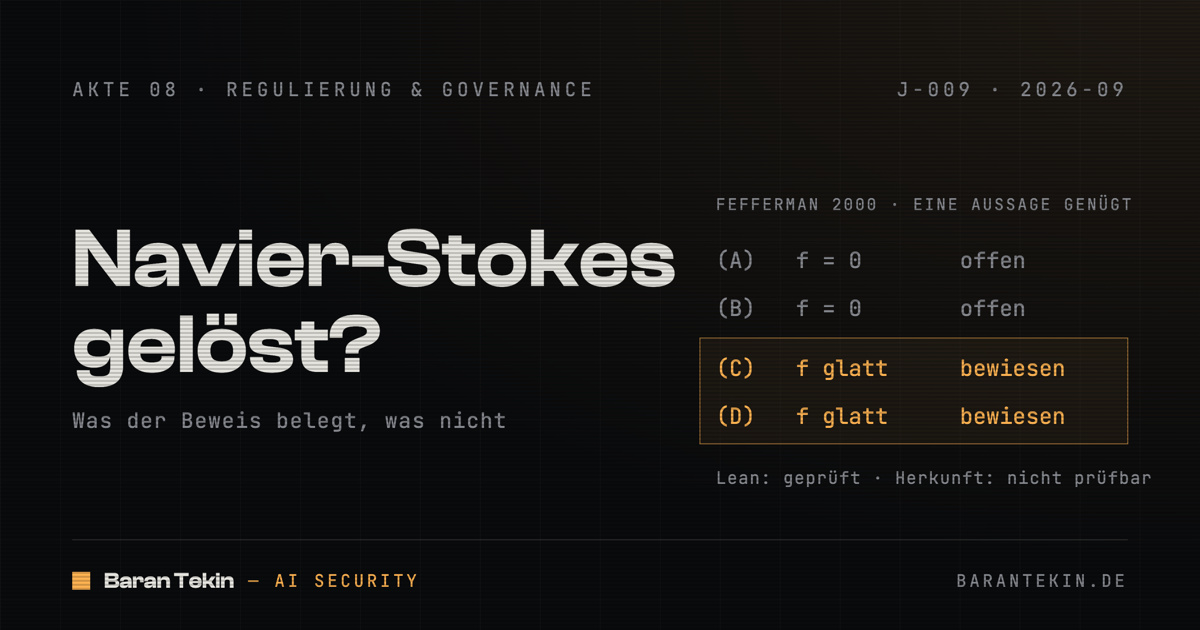
Kurz vor Mitternacht am 7. September 2026 veröffentlichte Tristan Buckmaster, Mathematiker an der NYU, eine vierseitige Stellungnahme, drei Preprints und ein Lean-Repository. Am Mittag des 8. September meldete OpenAI, ein internes Modell habe das Navier-Stokes-Existenz- und Glattheitsproblem gelöst, eines der sieben Millenniumsprobleme. Zwölf Stunden liegen zwischen den beiden Veröffentlichungen, und in ihnen steckt ein Streit darüber, wer was wann gesehen hat. „Navier-Stokes gelöst“ ist die Frage, die getippt wird; die ehrliche Antwort hat drei Teile, die in der Berichterstattung zu einem verschmelzen. Ist der Beweis korrekt? Wessen Methode ist es? Was haben die Systeme des Anbieters von der Arbeit der Gegenseite gesehen? Nur die erste Frage hat ein Instrument. Ein Lean-Prüfer lief 17 Stunden und hat sie entschieden. Die anderen beiden sind Governance-Fragen, und ich lese den Fall als Governance-Fall, weil es genau die Fragen sind, vor denen ein Team steht, sobald es unveröffentlichte Arbeit in den Coding-Agenten eines Anbieters gegeben hat. Meine Position: Nichts, was nach der Ankündigung passiert, beantwortet sie. Sie werden vor dem ersten Prompt beantwortet, durch einen Plan, eine Einstellung und einen Vertrag, oder sie bleiben offen.
Was ist das Navier-Stokes-Problem?
Das Navier-Stokes-Problem fragt, ob die Lösungen der dreidimensionalen inkompressiblen Navier-Stokes-Gleichungen zu glatten Anfangsdaten für alle Zeiten glatt bleiben oder ob eine Lösung eine Singularität entwickeln kann: einen endlichen Zeitpunkt, an dem die Geschwindigkeit des Fluids über jede Schranke wächst. Das Clay Mathematics Institute setzte die Frage im Jahr 2000 auf seine Liste der sieben Millenniumsprobleme, eine Million Dollar pro Problem. Die offizielle Problembeschreibung von Charles Fefferman stellt vier alternative Aussagen zur Wahl und sagt das ausdrücklich: „we ask for a proof of one of the following four statements“.
Die Gleichungen sind Newtons zweites Gesetz, geschrieben für ein Fluid, das als Kontinuum behandelt wird statt als Moleküle, mit einem Viskositätsterm für die innere Reibung und einer optionalen äußeren Kraft f (Schwerkraft, ein Propeller). Die vier Aussagen unterscheiden sich in zwei Schaltern, dem Gebiet und der Kraft:
| Aussage | Gebiet | Äußere Kraft f | Behauptung | Stand 13. September 2026 |
|---|---|---|---|---|
| (A) Existenz und Glattheit | R³ | f = 0 | Für jede glatte, abfallende, divergenzfreie Anfangsgeschwindigkeit existiert für alle Zeiten eine glatte Lösung mit beschränkter Energie | offen |
| (B) Existenz und Glattheit | R³/Z³ (periodische Box) | f = 0 | Dasselbe für periodische Anfangsdaten | offen |
| (C) Zusammenbruch | R³ | glattes f erlaubt | Es gibt eine glatte Anfangsgeschwindigkeit und eine glatte Kraft, für die keine glatte Lösung mit beschränkter Energie für alle Zeiten existiert | OpenAI, Theorem 1.1, Lean-geprüft |
| (D) Zusammenbruch | R³/Z³ | glattes f erlaubt | Dasselbe, periodisch | OpenAI, Korollar 10.6, Lean-geprüft |
Aus der Tabelle folgen zwei Dinge, und beide fehlen in den meisten Berichten. (A) bis (D) sind keine vier Stufen einer Aufgabe, sondern vier Türen, und Clay akzeptiert, wer eine davon öffnet. Und (C) und (D) widersprechen (A) und (B) nicht: Ein Fluid, das eine glatte äußere Kraft in eine Singularität treiben kann, sagt nichts über ein Fluid, das man in Ruhe lässt. Die Frage ohne Kraft, die die meisten Analytiker meinen, wenn sie „Navier-Stokes“ sagen, bleibt offen; Terence Tao schrieb am 7. September: „it should even be possible to do without the forcing term“ (Tao, 2026). Der Weg über eine glatte Kraft ist zugleich der Weg, den Buckmaster meint: der, den „Luis and Diego opened and the one Levent and I had quietly chosen to attack. Almost nobody else I know of was working on it“ (Buckmaster, 2026).
Ist das Navier-Stokes-Problem gelöst?
Nach dem Text von Clay ja, nach dem Verfahren von Clay noch nicht, und der Abstand zwischen beidem wird in Jahren gemessen. Es gibt einen Präzedenzfall. Poincaré stellte seine Vermutung 1904 auf, Perelman veröffentlichte seine Beweise 2002 und 2003 auf arXiv, Clay vergab den Preis am 18. März 2010 (Clay Mathematics Institute), und Perelman lehnte ihn ab (phys.org, 2010). Sieben Jahre vom Preprint zum Preis sind das Tempo des Instituts, und seine Regeln sind dafür geschrieben: „CMI does not accept direct submission of proposed solutions“, Veröffentlichung in einem qualifizierten Publikationsorgan, „At least two years must have passed since publication“, „general acceptance in the global mathematics community“. OpenAIs Arbeit ist ein PDF auf einem CDN; die Uhr läuft noch nicht, und OpenAI beabsichtigt nach eigener Aussage nicht, den Preis zu beanspruchen: „We do not intend to claim the Millennium Prize for this result“ (OpenAI, 2026). „Gelöst“ ist nach Clays Text richtig und nach Clays Verfahren verfrüht. Beide Hälften zählen.
Was hat OpenAI bewiesen?
OpenAIs Arbeit „Finite time blowup for Navier–Stokes“ (166 Seiten, 8. September 2026) formuliert als Theorem 1.1: Für jede positive Viskosität gibt es eine glatte äußere Kraft mit kompaktem Träger in Raum und Zeit, unter der ein Fluid aus der Ruhe vor dem Zeitpunkt 1 eine unbeschränkte Geschwindigkeit entwickelt, während seine kinetische Energie beschränkt bleibt; der kompakte Träger erlaubt es, die Konstruktion in die periodische Box zu verpflanzen, was (D) als Korollar 10.6 liefert (OpenAI, Paper). Ausgeschrieben hat die Aussage sechs Bestandteile, und jeder entspricht einem Teil von Feffermans (C):
Theorem 1.1 (OpenAI, 2026-09-08)
Viskosität:  ν > 0, beliebig
Kraft:       f ∈ C_c^∞(R³ × (0,∞); R³)
             glatt, kompakter Träger in Raum und Zeit
Start:       u(·, 0) = 0
             Fluid in Ruhe
Träger:      supp u(·,t) ∪ supp p(·,t) ⊂ K
             ein Kompaktum K, für alle 0 ≤ t < 1
Energie:     sup_{0≤t<1} ‖u(t)‖_L² < ∞
             kinetische Energie beschränkt
Blowup:      lim sup_{t↑1} ‖u(t)‖_L∞ = ∞
             Geschwindigkeit unbeschränkt vor t = 1
=> keine glatte Lösung mit beschränkter Energie
   auf R³ × [0,∞): Aussage (C)
=> kompakter Träger: dieselbe Konstruktion
   auf T³ = R³/Z³: Aussage (D)
Das Bild, das OpenAI dazu liefert, ist ein Wirbel, der sich nach innen windet und sich entlang seiner Achse „like spaghetti“ streckt, dabei schrumpft und schneller wird, während die Terme der Gleichung groß werden und sich so genau aufheben, dass die äußere Kraft glatt bleibt. Die Lean-Formalisierung liegt im Repository openai/NavierStokesAndEuler (Lean 4.34.0-rc2, Mathlib); dessen README nennt beide Ergebnisse als Alternativen (C) und (D) und liefert eine Anleitung zur unabhängigen Prüfung mit Comparator.
Wie der Beweis gefunden wurde, zählt für alles Weitere, deshalb hier OpenAIs eigene Darstellung. Seit dem 28. August trainierte das Unternehmen ein neues internes Modell, „significantly more capable than GPT‑6 Astra“, dem am 3. September vorgestellten Modell. Für Dienstag, den 1. September, notiert OpenAI: „we heard rumors that two Millennium Prize problems had been resolved“, und ein Anlauf auf alle offenen Millenniumsprobleme begann. Die Agenten liefen in Gruppen, konnten eine zwischengespeicherte Kopie des Internets lesen und Code ausführen; getrennte Gruppen bekamen die Varianten (A)/(B) und (C)/(D). Eine Nebenaufgabe fiel zuerst, die Euler-Gleichungen ohne Kraft (Viskosität null): „Nearly 100 agents worked together for approximately 50 hours“, eine 57-seitige Arbeit. Dann zog OpenAI Agenten von den anderen Problemen ab, gab ihnen die Euler-Lösung als Ausgangspunkt („prompted these agents with the Euler resolution“), wechselte während des Laufs auf ein weiter trainiertes Modell und führte die Gruppen zusammen: „cross-pollinated the agent groups by using Codex to consolidate the most useful insights from each agent group“. Die Navier-Stokes-Gruppe umfasste „on the order of 10,000 concurrent agents“; das Ergebnis kam am Samstag, dem 5. September, rund 88 Stunden nach dem Start; „Lean formalization and verification took an additional 17 hours via GPT‑6 Astra“. Der Anlauf schickte 2,7 Millionen Nachrichten und verbrauchte etwa 130 Milliarden Output-Tokens (OpenAI, 2026).
Zwei Details dieser Darstellung tragen später Gewicht. Der Lauf begann auf ein Gerücht hin, vier Tage nach Trainingsbeginn des Modells. Und der Lauf wurde gesteuert: Menschen entschieden, welches Ergebnis welche Agenten bekommen, und Codex, das Produkt, führte die Zwischenergebnisse zusammen. OpenAI ergänzt, man habe „the same strict safeguards that we apply to all our frontier model evaluations, including monitoring and isolation“ beibehalten; was ein Schwarm von OpenAI-Agenten mit weniger von beidem anstellt, dokumentiert der Beitrag zum OpenAI-Hugging-Face-Vorfall vom Juli.
Was prüft der Lean-Beweisassistent, und was nicht?
Lean ist ein Beweisassistent: Ein kleiner, überprüfbarer Kern prüft, ob jeder Schritt eines formalen Beweises nach den Regeln der Logik aus früheren Schritten und aus den Definitionen und Sätzen der Bibliothek Mathlib folgt. Wenn das Projekt baut, ist die formale Aussage ein Satz. Mehr sagt ein grüner Build nicht. Er sagt nicht, dass die formale Aussage die gemeinte ist, nicht, wer die Idee hatte, und nicht, woher die Eingaben stammen.
Die erste Lücke ist eine Leseaufgabe, und eine endliche. Ich habe Theorem 1.1 neben Feffermans (C) gelegt. (C) verlangt eine glatte, divergenzfreie Anfangsgeschwindigkeit und eine glatte Kraft, die zwei Abfallbedingungen erfüllen und zu denen keine glatte Lösung mit beschränkter Energie für alle Zeiten existiert. Die Anfangsgeschwindigkeit null ist glatt, divergenzfrei und fällt ab; eine glatte Kraft mit kompaktem Träger erfüllt jede Abfallbedingung; die Energieschranke steht im Theorem. Die formale Aussage passt zur informellen. Diese Prüfung hat zwanzig Minuten und einen PDF-Betrachter gekostet, und sie ist der einzige Teil der Affäre, den ein Dritter zu Ende bringen kann. Alles andere, was im Streit steht, liegt außerhalb des Kerns, und jedes Stück hat sein eigenes Instrument:
- Ist der Beweis korrekt? Instrument: der Lean-Kern plus eine menschliche Lektüre der Aussage. Beantwortet.
- Wessen Methode ist es? Instrument: die Literatur, die Zeitstempel, die Lektüre beider Beweise. Teilweise beantwortet; für den Rest gibt es Clays zwei Jahre.
- Was haben OpenAIs Systeme von der Arbeit der Gegenseite gesehen? Instrument: OpenAIs interne Protokolle. Ein externes Instrument gibt es nicht, und es wird keines geben.
Wer hatte die Methode zuerst?
Beide Seiten geben dieselbe erste Antwort, und es sind Namen, die keine Schlagzeile trägt. Buckmaster: „The credit for the basic idea of this program goes to Diego Córdoba and Luis Martínez-Zoroa, who for several years have been exploring the construction of forced blow ups.“ Tao beschreibt das Programm als stufenweisen Aufbau der Lösung, „repeatedly adding small high frequency corrections to a previous (forced) solution“, und verlinkt den Preprint der beiden (arXiv:2410.22920). OpenAIs Arbeit zitiert Córdoba und Martínez-Zoroa in der Einleitung. Von dort an gehen die Chronologien auseinander: zwei Darstellungen, die in den meisten Fakten übereinstimmen und in deren Bedeutung nicht.
- 15. August 2026. Alpöge und Buckmaster beweisen in einer persönlichen Zusammenarbeit, „free of any institutional agreements or official involvement by either of our employers“, den Blowup mit glatter Kraft für Boussinesq und 3D-Euler. Werkzeuge laut Buckmaster: „Anthropic's Claude, OpenAI's Codex, especially with GPT-5.6 Sol and, more recently, Astra“; er bezahlt „a large bill to OpenAI“ aus eigenen Forschungsmitteln. Lean prüft den Beweis am 22. August.
- 28. August. OpenAI beginnt das Training seines neuen internen Modells.
- 1. September. OpenAI hört das Gerücht und startet die Agenten. Buckmaster schreibt, Alpöge „had received tips that information about our progress had been passed to OpenAI“.
- 3. September. Buckmaster schreibt einem Mathematiker bei OpenAI, das Gerücht beziehe sich vermutlich auf ihn, und bittet, niemand möge eine KI-Ausarbeitung überstürzt veröffentlichen. Antwort am selben Tag, verbunden mit dem Angebot von Rechenleistung.
- 5. und 6. September. Die Agenten sind fertig; Lean ist am 6. durch. Am Sonntag, dem 6., um 12:45 Uhr wird Buckmaster gebeten, „at any point today“ zu sprechen. Zwei Gespräche, Sébastien Bubeck in beiden, Alpöge in keinem. Ihm wird gesagt, das Ergebnis sei „Existence of forced blowup in R3 and T3“, „option c and d in Fefferman“, rund 100 Seiten. Er fragt, wann der erste Prompt abgeschickt wurde; die Antwort, nach einiger Zeit: „in the past few days, after information about our work had reached OpenAI“. Er fragt, ob das Modell „had been trained on, or had access to, our sessions in Codex, into which we had been putting all our drafts for the whole of this project. I was told the model did not look up user data. I asked again, about training, and I did not get an answer.“ Zwei Vorschläge: Er veröffentlicht Euler und OpenAI am Tag danach Navier-Stokes, oder er schreibt OpenAIs Ergebnis selbst auf, ohne Alpöge als Autor. Er lehnt beides ab und kündigt an, an die Öffentlichkeit zu gehen. Die Antwort, die er wiedergibt: „Why would you ruin your career?“
- 7. September, Nacht. Stellungnahme, drei Preprints, Lean-Repository. Sein letztes Wort zu den Daten: „I have not seen OpenAI's proof. I do not know what their model did, or how. I do not know whether our data was used. I am not accusing anyone of anything.“
- 8. September, Mittag. OpenAIs Ankündigung erkennt „the priority of their work on forced Euler“ an, erklärt, „no specific user data was accessed in order to solve this problem“, und enthält in ihrer ersten Fassung den Satz: „While unlikely, we cannot rule out that de-identified data derived from their usage of our products helped improve our models“ (Wortlaut, wie ihn in derselben Woche das Smithsonian Magazine zitiert). Bubeck gegenüber Fortune: „We did not use their prompts or proofs to prompt our models or direct our agents.“
- 10. September. OpenAI ersetzt den Satz: „Following an investigation, we have confirmed that Buckmaster's Codex prompts over the two months preceding this announcement and paper on September 8, 2026, could not have influenced the system in any way, including through training. The OpenAI internal model used for this result was developed through large-scale reinforcement learning on top of a previously pretrained model.“
Zur Methode ist die Aktenlage klarer als der Ton. OpenAIs Euler-Ergebnis ist eines ohne Kraft, das von Alpöge und Buckmaster eines mit; OpenAIs Navier-Stokes-Ergebnis ist eines mit Kraft, also die Tür, die die beiden gewählt hatten. OpenAI schreibt, die Beweise „differ significantly“; Buckmaster hatte OpenAIs Beweis nicht gesehen, als er schrieb. Ein Sachkonflikt bleibt offen: OpenAIs Seite sagt, die beiden hätten „using an internal Anthropic model“ gearbeitet, Buckmaster nennt Claude, Codex, GPT-5.6 Sol und Astra und bezeichnet die Zusammenarbeit als persönlich. Beides steht in den Akten, und von außen lässt es sich nicht auflösen. Fest steht der Preis des Wettlaufs. Buckmaster nennt seine eigene Euler-Ausarbeitung „AI slop“ und schreibt, die beiden „would have preferred to spend weeks turning the LLM generated proofs into something readable“; Tao schreibt, sie „were forced to release their preliminary preprints before they were completely digested and polished, due to external events“, und: „the actual solving of these problems is only a proxy goal for the primary goal of developing mathematical understanding and insight“.
Was hat OpenAI von den Codex-Sitzungen gesehen?
Niemand außerhalb von OpenAI kann das wissen, und dieser Satz ist der Befund, keine Klage. Die Erklärung vom 10. September ist die stärkste, die ein Anbieter abgeben kann: eine Untersuchung, „could not have influenced the system in any way, including through training“, ein Modell, das per Reinforcement Learning auf einem früher vortrainierten Modell aufgebaut wurde. Sie ist zugleich eine Erklärung der Partei, die die einzigen Protokolle hält, und zwei ihrer Eigenschaften verdienen eine langsame Lektüre. Sie erfasst „Buckmaster's Codex prompts over the two months preceding“ den 8. September, während die Entwürfe „for the whole of this project“ in Codex gingen, nach seiner Darstellung rund ein Jahr. Und binnen 48 Stunden bewegte sich der Wortlaut von „cannot rule out“ über „categorically impossible“ (ein OpenAI-Sprecher gegenüber der ABC) zu „could not have influenced ... in any way“. Ich habe keinen Grund, an der letzten Fassung zu zweifeln. Ich habe auch keine Möglichkeit, sie zu prüfen, Buckmaster ebenso wenig, und kein Team in derselben Lage hätte eine.
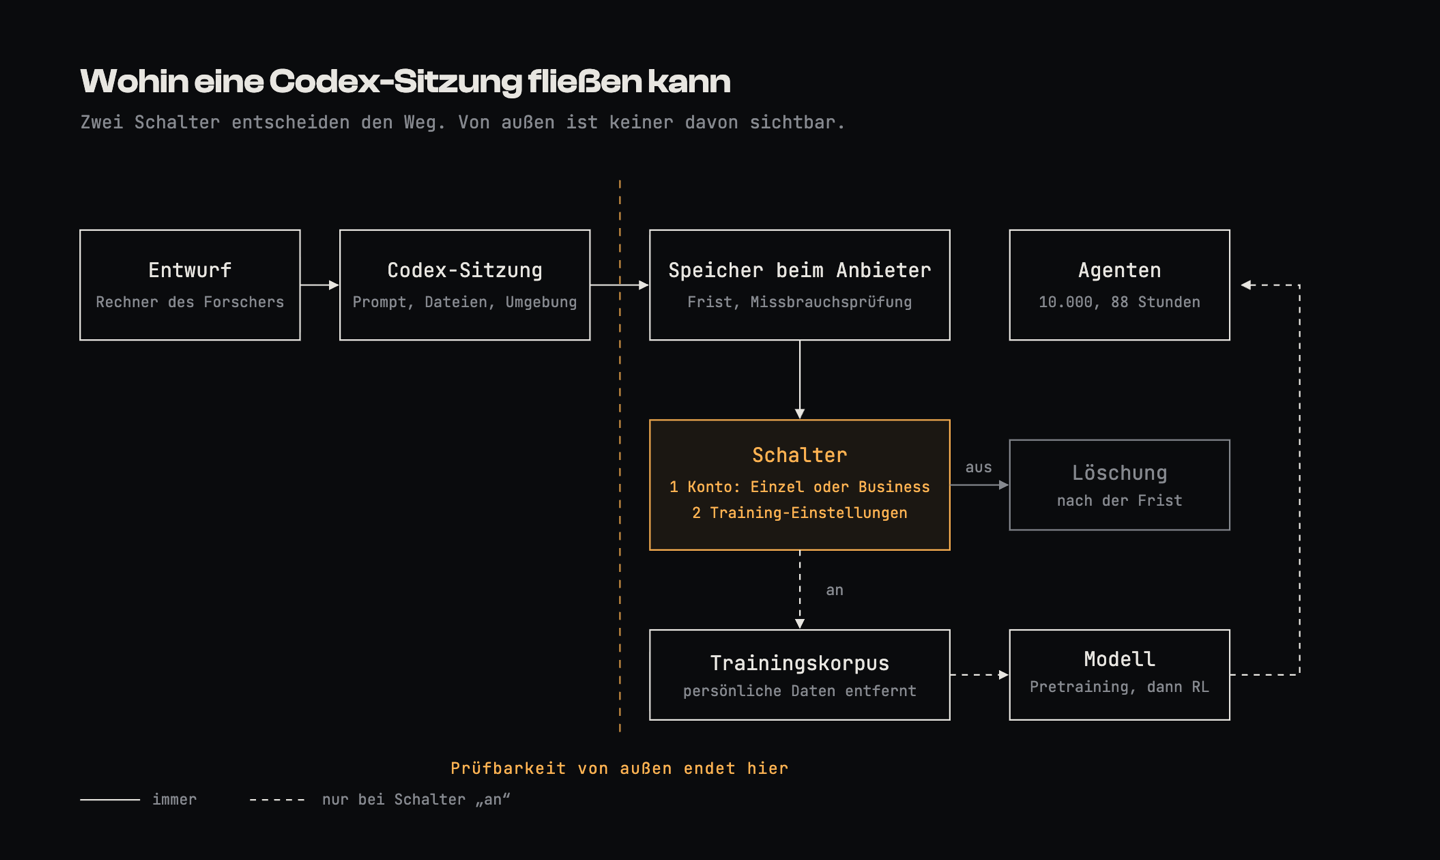
Prüfbar ist der Mechanismus, weil beide Anbieter ihn dokumentieren. Eine Coding-Agent-Sitzung verlässt den Rechner, landet für eine Aufbewahrungsfrist im Speicher des Anbieters und wandert von dort in einen Trainingskorpus oder eben nicht, abhängig von zwei Dingen: dem Plan, auf dem das Konto läuft, und einer Einstellung. So stand es am 13. September 2026 auf den Seiten der beiden Anbieter (ich habe beide an diesem Tag gelesen; OpenAIs Hilfeartikel trug den Vermerk „Updated: 2 days ago“):
| Produkt und Plan | Training auf Inhalte | Aufbewahrung | Schalter |
|---|---|---|---|
| OpenAI: Free, Plus, Pro (mit Codex) | Ja, solange nicht widersprochen | Temporäre Chats: 30 Tage, nie trainiert | „Improve the model for everyone“ aus; Codex Settings |
| OpenAI: Business, Enterprise, API | Nein, per Voreinstellung | Enterprise-Privacy-Seite | Nur per Opt-in |
| Anthropic: Free, Pro, Max (mit Claude Code) | Ja, wenn die Einstellung an ist | 5 Jahre (an), 30 Tage (aus) | Settings → Data privacy controls |
| Anthropic: Team, Enterprise, API | Nein, außer Development Partner Program | 30 Tage; Zero Data Retention auf Antrag | Vertrag, Organisations-Admin |
Die Zeilen tragen den Wortlaut der Anbieter. OpenAI im Help Center: „When you use our services for individuals such as ChatGPT and Codex, we may use your content to train our models“, und zum zweiten Schalter: „Codex has separate controls for allowing training on full environments ... adjusting your settings in the ChatGPT interface or privacy portal will not affect these“; Temporäre Chats werden nach 30 Tagen gelöscht und nie trainiert, der reguläre Verlauf bleibt; für Geschäftskunden: „By default, we do not train on any inputs or outputs from our products for business users“, mit Opt-in als einzigem Weg hinein (Data Controls FAQ). Anthropic zu den Verbraucherplänen: „including when they use Claude Code from accounts associated with those plans“, mit einer Wahl, die bis zum 8. Oktober 2025 fällig war (Anthropic, 2025); zu den kommerziellen, zu denen auch Bedrock, Vertex und Claude Gov zählen: „Anthropic does not train generative models using code or prompts sent to Claude Code under commercial terms“, Zero Data Retention für qualifizierte Enterprise-Konten (Claude-Code-Dokumentation).
Buckmasters Satz liest sich vor dieser Tabelle anders. Er bezahlte „a large bill to OpenAI“ aus Forschungsmitteln und gab alle Entwürfe in Codex. In welcher Zeile er stand, ist nicht öffentlich und von außen nicht zu ermitteln. Auf einem persönlichen Plan mit Voreinstellung galt die erste Zeile, und die Seite des Anbieters sagt, was diese Zeile bedeutet; auf einem Business-Plan oder über die API galt die zweite. Der Unterschied zwischen „unsere Sitzungen können Trainingsdaten gewesen sein“ und „unsere Sitzungen waren vertraglich ausgeschlossen“ war während der Sonntagsgespräche eine Kontoeinstellung, die niemand in diesen Gesprächen sehen konnte. Codex-Datenschutz und Claude-Code-Datenschutz sind an dieser Stelle keine Compliance-Themen, sondern die Frage, in welcher Zeile ein Projekt steht.
Wie schützt man unveröffentlichte Arbeit vor dem KI-Anbieter?
Indem vor dem ersten Prompt feststeht, auf welchem Produkt und Plan die Arbeit läuft, ob jeder Trainingsschalter aus ist und wo jeder sitzt, welche Aufbewahrung gilt und wie das Team seine eigene Priorität ohne Hilfe des Anbieters belegt; und indem das mit Datum aufgeschrieben wird, weil sich die Seite des Anbieters ändern wird und die Akte sagen muss, welche Fassung galt. Die Frage, die Buckmaster am 6. September stellte, ist am 6. September unbeantwortbar. Am Tag, an dem ein Projekt beginnt, ist sie eine Zeile.
Die Akte ist eine kleine Datei neben dem Projekt:
# ki-werkzeuge.yaml: Datenbedingungen eines Projekts,
# festgelegt vor dem ersten Prompt
projekt: euler-blowup-glatte-kraft
erfasst: 2026-09-13
werkzeuge:
  - produkt: OpenAI Codex (CLI, IDE, Cloud)
    konto: ChatGPT Business
    # persönliche Pläne: Training per Voreinstellung an
    training: aus, durch den Plan
    zweiter_schalter: >
      Codex Settings > training on full environments = aus
    aufbewahrung: >
      laut Enterprise-Privacy-Seite, Fassung vom 2026-09-13
    beleg: https://help.openai.com/en/articles/5722486
    # Hilfeartikel trug am 2026-09-13 „Updated: 2 days ago“
  - produkt: Claude Code
    konto: Team
    # Free/Pro/Max: Schalter, 5 Jahre Aufbewahrung wenn an
    training: aus, kommerzielle Bedingungen
    aufbewahrung: 30 Tage; Zero Data Retention beantragt
    beleg: https://code.claude.com/docs/en/data-usage
prioritaetsnachweis:
  vor_jedem_upload: >
    git commit, signierter Tag, externer Zeitstempel
    (z. B. OpenTimestamps)
  zweck: >
    belegt, dass der Entwurf zum Zeitpunkt T existierte,
    unabhängig von jedem Anbieterprotokoll
pruefung:
  wann: >
    bei jeder Änderung der Anbieterbedingungen;
    das erfasste Fassungsdatum ist der Auslöser
Drei Zeilen tragen die Datei. Die Kontozeile, weil sie die Zeile der Tabelle entscheidet und das Einzige ist, was keine Untersuchung im Nachhinein ändern kann. Die Zeile mit dem zweiten Schalter, weil die Codex-Einstellung für ganze Umgebungen als unabhängig vom ChatGPT-Schalter dokumentiert ist, und ein Team, das einen Schalter umgelegt hat, hat genau einen Schalter umgelegt. Und der Prioritätsnachweis, weil ein signierter, extern zeitgestempelter Commit der einzige Herkunftsbeleg ist, der nicht in der Infrastruktur des Anbieters liegt. Alpöges und Buckmasters Lean-Prüfung vom 22. August ist genau diese Art von Beleg, und deshalb hat die Prioritätsfrage, anders als die Datenfrage, eine dokumentierte Antwort.
Was nicht hilft
- „Der Anbieter hat es dementiert.“ Ein Dementi ist eine Aussage der Partei, die die Protokolle hält, und die Navier-Stokes-Formulierungen zeigen, dass eine solche Aussage binnen 48 Stunden Umfang und Stärke wechseln kann, während die Fakten dieselben bleiben. Von außen lässt sie sich weder bestätigen noch widerlegen.
- „Wir nutzen die API, also wird nichts trainiert.“ Für API, Business und Enterprise stimmt das per Voreinstellung. Aber Codex, angemeldet mit einem persönlichen ChatGPT-Konto, ist das Produkt für Einzelpersonen, und der Schalter für ganze Umgebungen ist vom ChatGPT-Schalter getrennt. Über die Zeile entscheidet das Konto, mit dem die CLI angemeldet ist, nicht der Produktname.
- „Wir haben widersprochen, also sind die alten Sitzungen sicher.“ Der Widerspruch wirkt nur nach vorn: „After you opt out, we won't train our models on your new conversations.“ Und ein Daumen hoch unter einer Antwort schickt „the entire conversation associated with that feedback“ ins Training, auch nach dem Widerspruch.
- „Ein Lean-Zertifikat klärt, wer zuerst war.“ Lean klärt, dass der Satz ein Satz ist; ein Repository-Zeitstempel klärt, dass die Datei zu dieser Zeit existierte; keines von beidem klärt, ob zwei Herleitungen unabhängig waren. Das klärt nur die Lektüre beider Beweise, die Aufgabe, für die Clays zwei Jahre da sind.
Ein Lean-Zertifikat ist die Statikprüfung eines Beweises. Sie bestätigt, dass die Konstruktion trägt. Sie sagt nicht, wer die Pläne gezeichnet hat, und nicht, wessen Pläne auf dem Tisch lagen, während gezeichnet wurde.
Fazit
„Navier-Stokes gelöst“ ist wahr nach dem Text, den Clay geschrieben hat, und noch nicht anerkannt nach dem Verfahren, das Clay durchsetzt: (C) und (D) sind Sätze in Lean, (A) und (B) sind offen, und der Preis braucht eine Fachzeitschrift und zwei Jahre. Die Korrektheitsfrage hat 17 Stunden Rechenzeit gekostet und wird einen Gutachter einige Wochen kosten. Die anderen beiden Fragen haben keinen Preis, zu dem sie sich nachträglich kaufen ließen. Wer unveröffentlichte Arbeit in den Agenten eines Anbieters gibt, hat bereits entschieden, in welcher Zeile der Tabelle er steht, ob er hingesehen hat oder nicht. KI-Governance, in dem schlichten Sinn, den diese Akte Regulierung & Governance meint, macht daraus eine Entscheidung mit Datum und Dokument statt einer Entdeckung in einem Sonntagsgespräch. Korrektheit lässt sich nachträglich kaufen. Herkunft wird vor dem ersten Prompt festgelegt, oder nie.